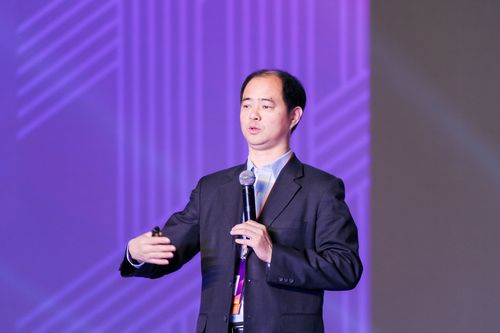
深度学习在图像识别、自然语言处理、语音识别等领域取得了举世瞩目的成就,推动了人工智能产业的蓬勃发展。微软亚洲研究院副院长、微软杰出科学家崔宏禹(英文名:Hongyu Cui)指出,尽管深度学习技术不断进步,但其根本性瓶颈仍然存在——在神经脑科学取得重大突破之前,深度学习很难实现真正的通用人工智能。
深度学习的光环与隐忧
深度学习的核心是人工神经网络,其灵感来源于人脑神经元之间的连接机制。通过多层非线性变换,深度学习模型能够从海量数据中自动提取特征,完成复杂的模式识别任务。崔宏禹在多个公开场合表示,深度学习在特定任务上的表现已经达到甚至超越人类水平,但这背后隐藏着深层次的局限。
“深度学习本质上是一种统计模型,依赖大量标注数据和计算资源,它善于拟合数据中的相关性,却难以真正理解因果逻辑。”崔宏禹解释道。当前深度学习模型缺乏可解释性、鲁棒性不足、容易受到对抗样本攻击,且在新场景下的泛化能力有限。这些问题并非仅靠增加数据和模型参数就能解决。
神经脑科学:深度学习的“源代码”尚未破解
崔宏禹认为,深度学习之所以面临瓶颈,是因为我们对大脑工作机制的理解仍然非常有限。人脑具有惊人的能效比和学习能力,能够在少量样本下快速学习新概念,并具备推理、规划和创造能力。而当前的深度学习模型需要数百万甚至数十亿参数、海量计算资源才能达到类似的语言生成能力,但本质上仍是“模式匹配”,缺乏真正的认知能力。
“神经脑科学还没有突破,我们不知道大脑是如何编码信息、如何形成记忆、如何进行抽象推理的。深度学习只是在外围模仿,没有触及智能的本质。”崔宏禹说。在他看来,只有神经脑科学取得根本性突破,揭示大脑信息处理的基本原理,深度学习才有可能实现从“感知智能”到“认知智能”的跃迁。
突破瓶颈需要跨学科协同
针对深度学习面临的瓶颈,崔宏禹提出应加强跨学科研究,将神经科学、认知心理学与人工智能深度结合。“我们需要借鉴神经脑科学的最新发现,重新设计神经网络架构和学习算法。”他举例说,从脉冲神经网络(Spiking Neural Networks)到类脑计算芯片,这些探索都介于神经科学与深度学习之间,代表了未来的发展方向。
他也强调,小样本学习、因果推理、自监督学习等方向值得关注。这些技术试图摆脱对大数据的依赖,赋予模型更强的推理和知识迁移能力。崔宏禹坦言,这些努力仍属于“搭桥”阶段,尚未重构深度学习的基础框架。
回归理性,务实推进
在崔宏禹看来,深度学习的发展需要保持理性预期。“当前深度学习在工业界的大规模应用有其合理边界,我们不应夸大其能力。”他建议企业落地AI项目时聚焦具体场景,避免在历史性的“通用人工智能”未成熟之前投入过高成本。
另一方面,他呼吁学术和产业界持续关注神经脑科学的进展,“如果我们真正理解大脑的运行机制,今天深度学习的各项瓶颈将迎刃而解——这只是时间问题。’
对崔宏禹保持着审慎乐观:在当前数据库和算力的支持下,我们可以期待深度学习在垂直领域取得更可靠的表现;但对于真正的智能革命,一切还有待脑科学的突破。